开发语言未说明
资源大小15.09MB
运行环境Windows / macOS / Linux
资源状态可查看
BrowserUse 的定位与运行方式
BrowserUse 把大语言模型和真实浏览器连接起来,让开发者用自然语言描述任务,由 AI 根据页面内容自行判断点击、输入或跳转。
与需要预先写死按钮位置和操作顺序的传统自动化不同,BrowserUse 更强调直接给出最终目标,执行路径由 AI 结合当前页面动态决定。
从任务描述到网页操作
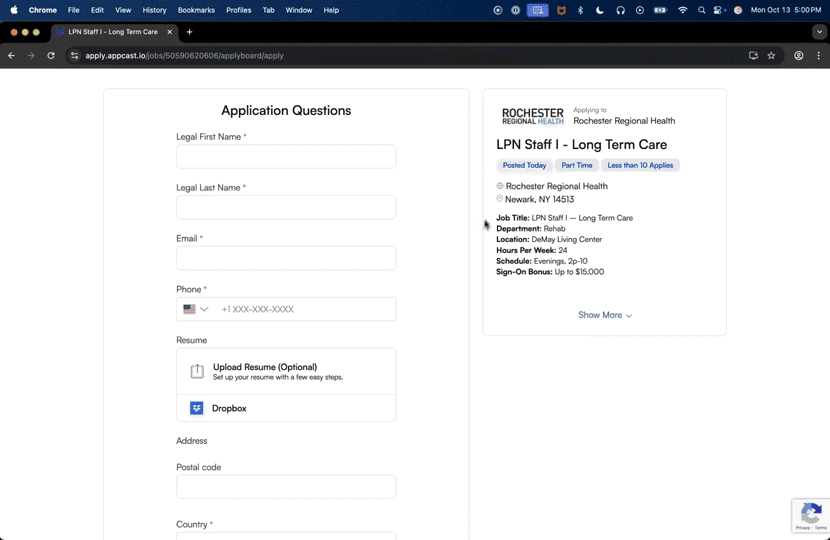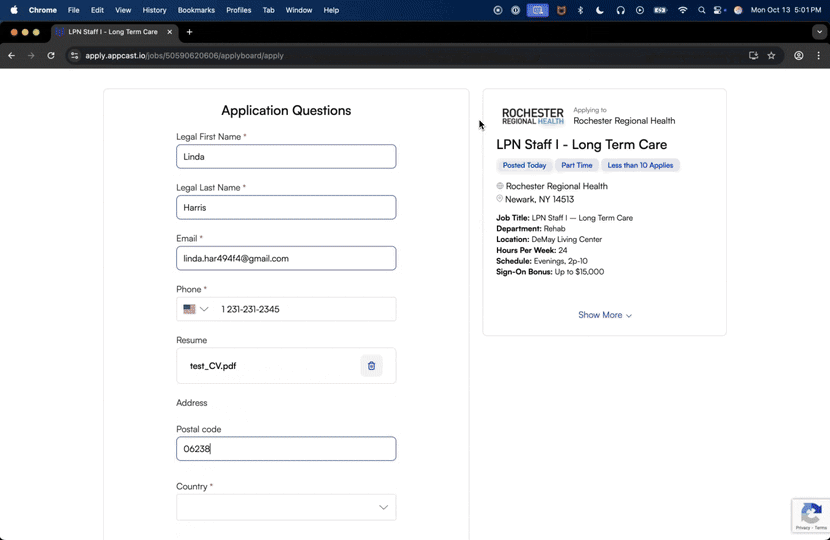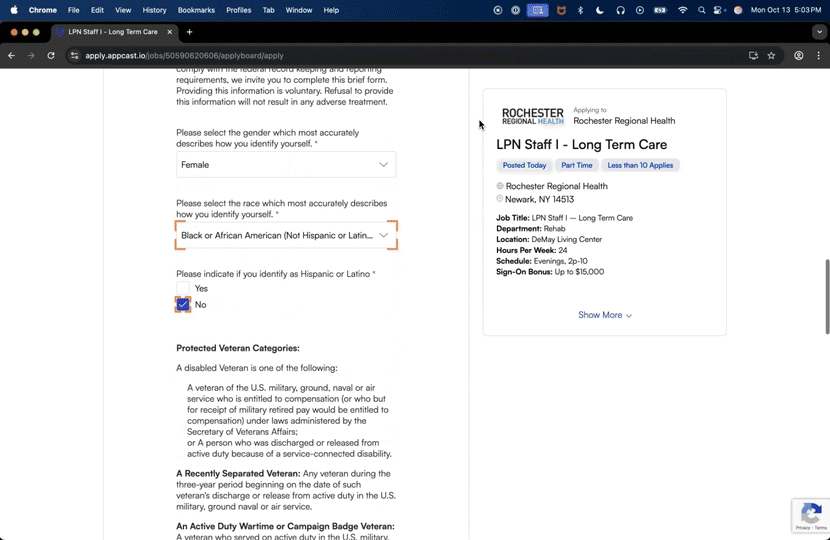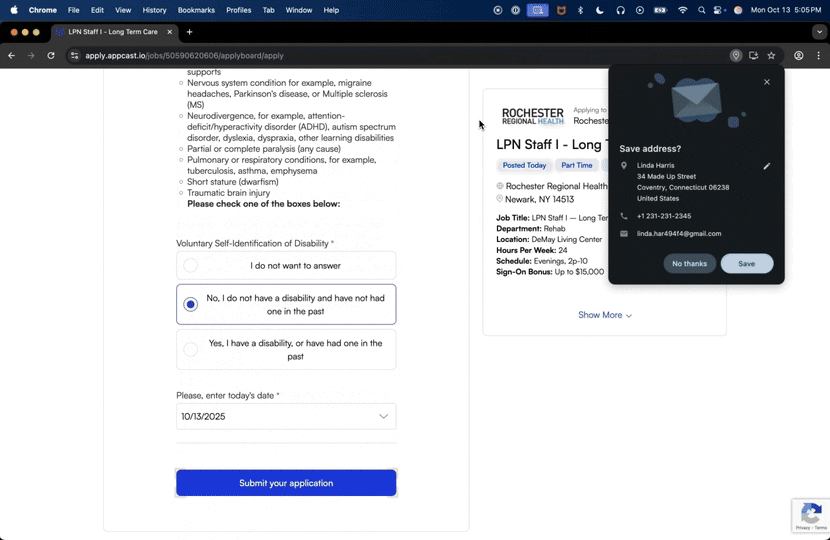
在 Python 程序中创建 Agent 后,可以为它提供一段自然语言任务,例如打开指定网站、搜索关键词、读取页面信息、填写表单或整理搜索结果。
对于需要跨多个页面才能完成的工作,BrowserUse 可以按照任务目标持续执行。
模型接入与可扩展方向
开发者可以根据项目需求接入兼容的大语言模型,并配置对应的 API Key、模型名称及其他连接参数。
实际项目还可以增加任务队列、执行日志、错误重试和任务状态管理等机制。如果需要长期运行大量浏览器任务,可根据规模选择自行部署开源版本,或使用 Browser Use Cloud 提供的托管基础设施;
安装前后的核对建议
开始前建议准备独立的 Python 虚拟环境,避免与其他项目依赖冲突,并按当前版本的官方依赖要求安装 BrowserUse 及所需组件。
生产环境部署时,需要重点考虑浏览器资源消耗、任务并发数量、异常重试、网络环境以及第三方网站的使用…
界面预览