开发语言未说明
资源大小113.28MB
运行环境Windows / macOS / Linux / Web
资源状态可查看
从文档识别到结构化输出
PaddleOCR 是由百度飞桨团队开发并开源的多语言 OCR 工具包与文档 AI 引擎,能够把 PDF 文档、扫描件、截图等图像内容转化为结构化的 JSON 或 Markdown 数据。
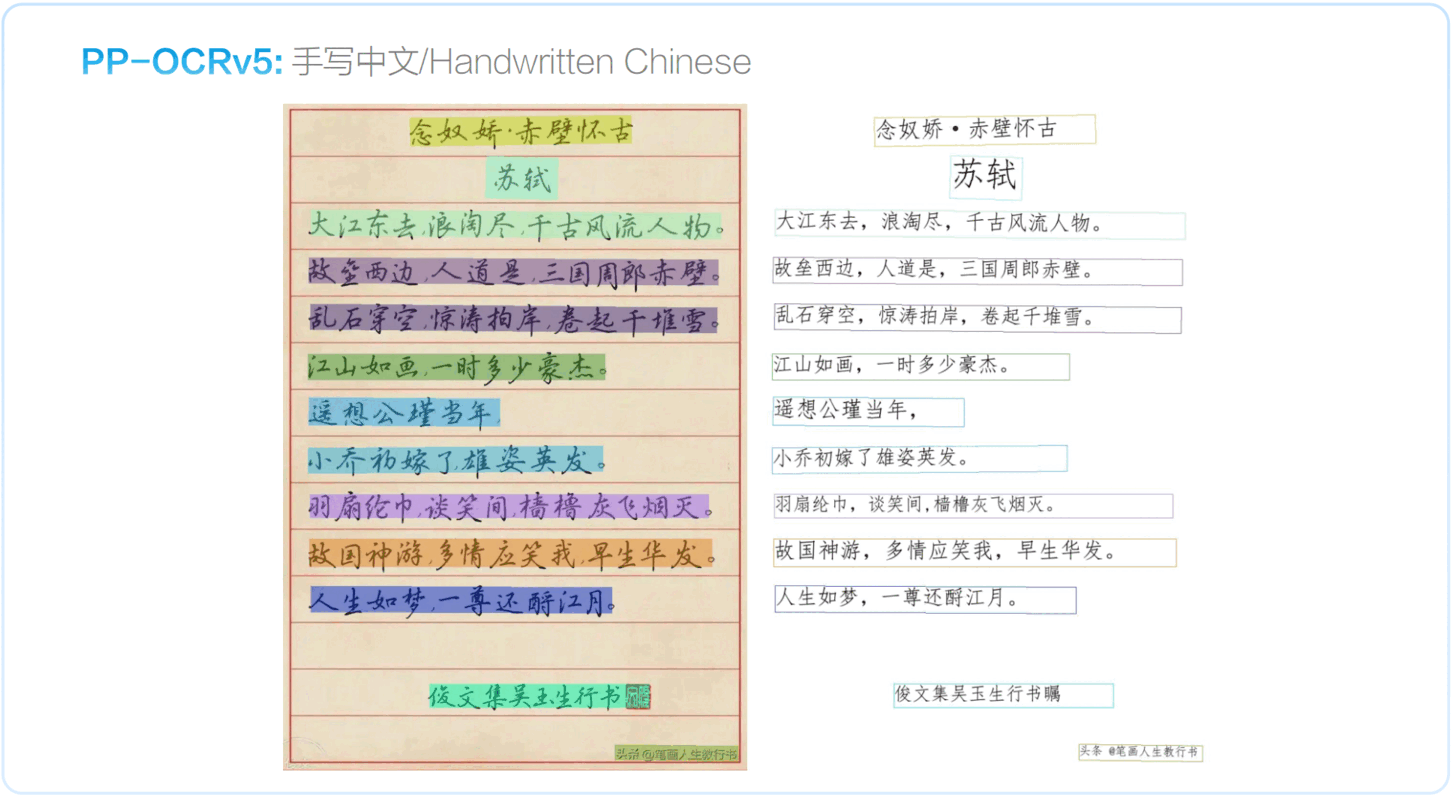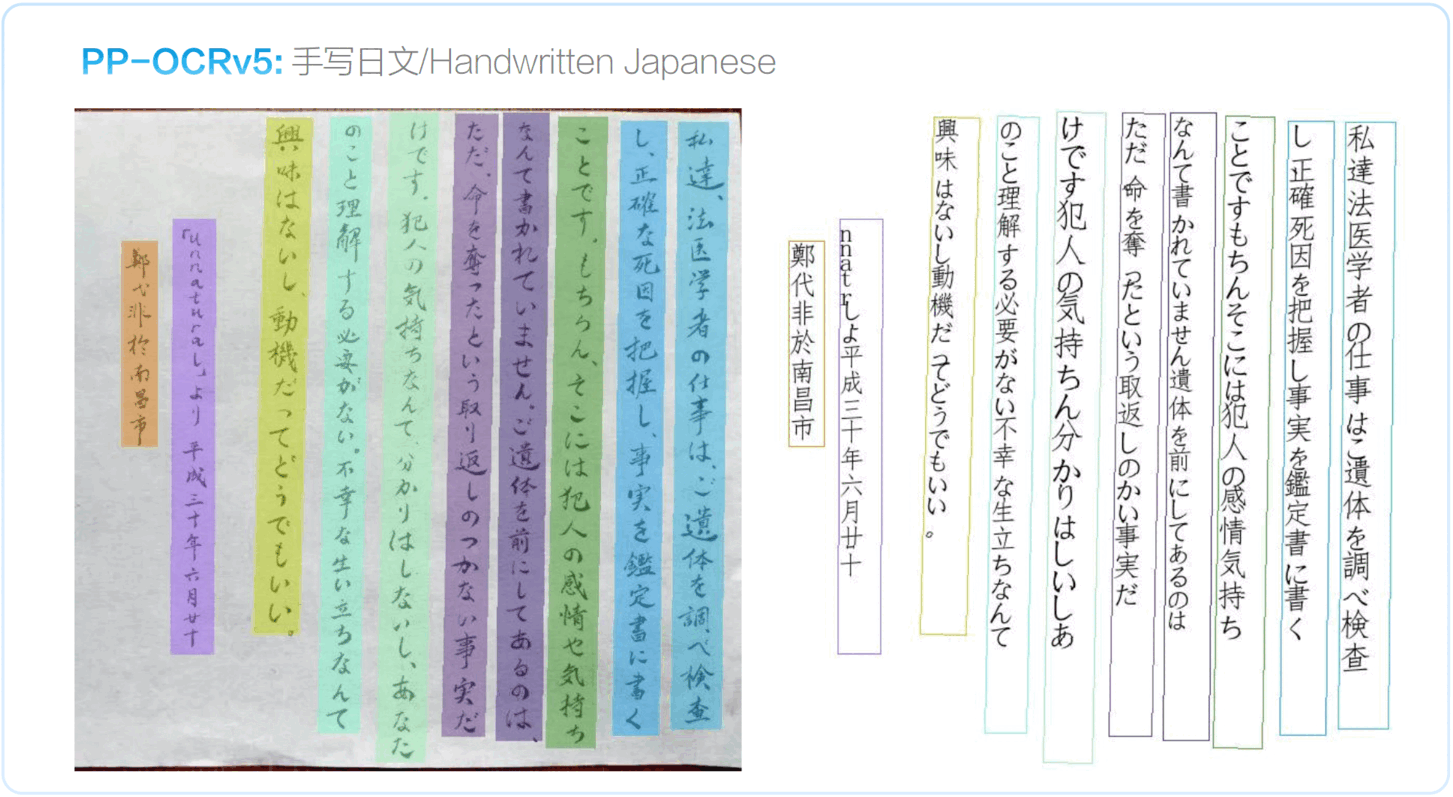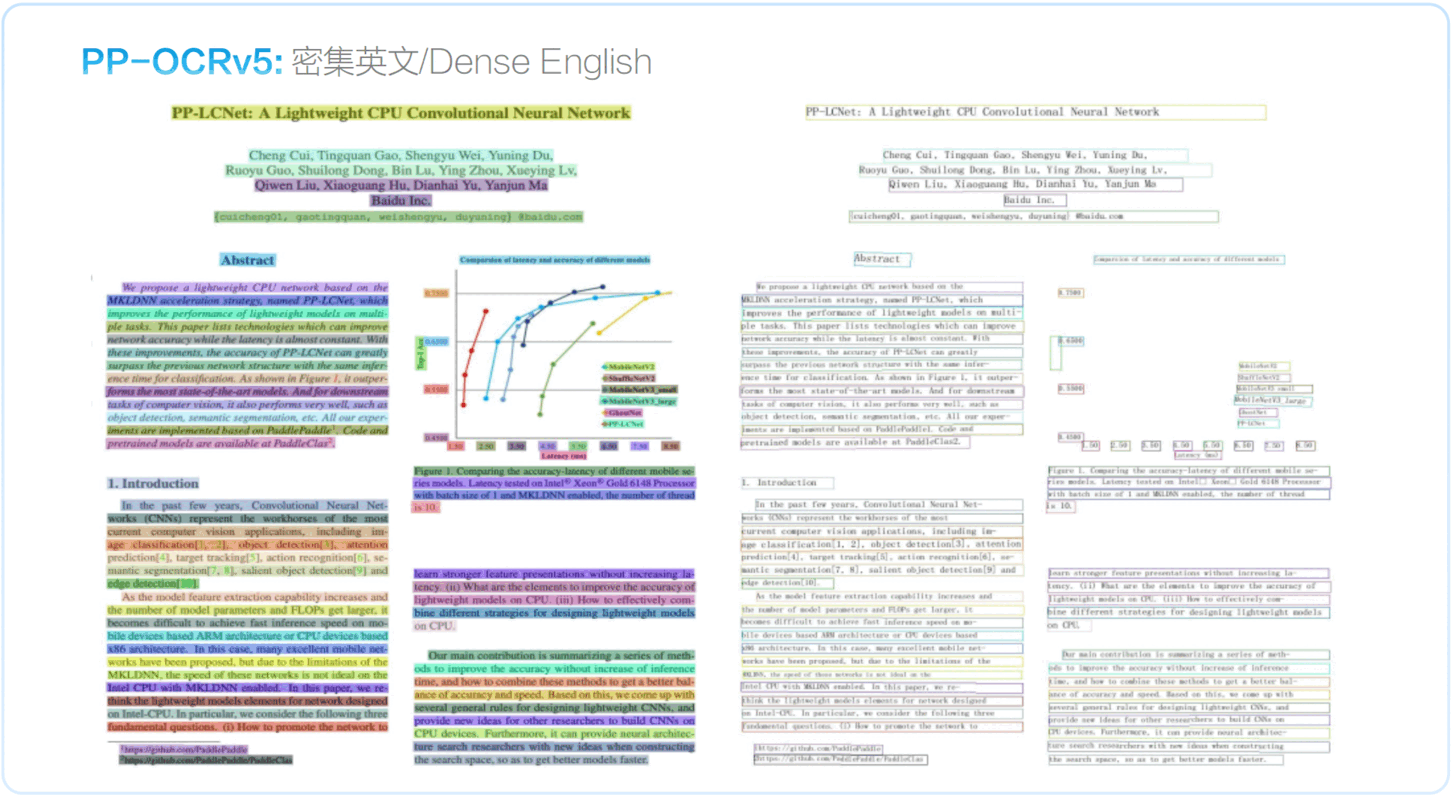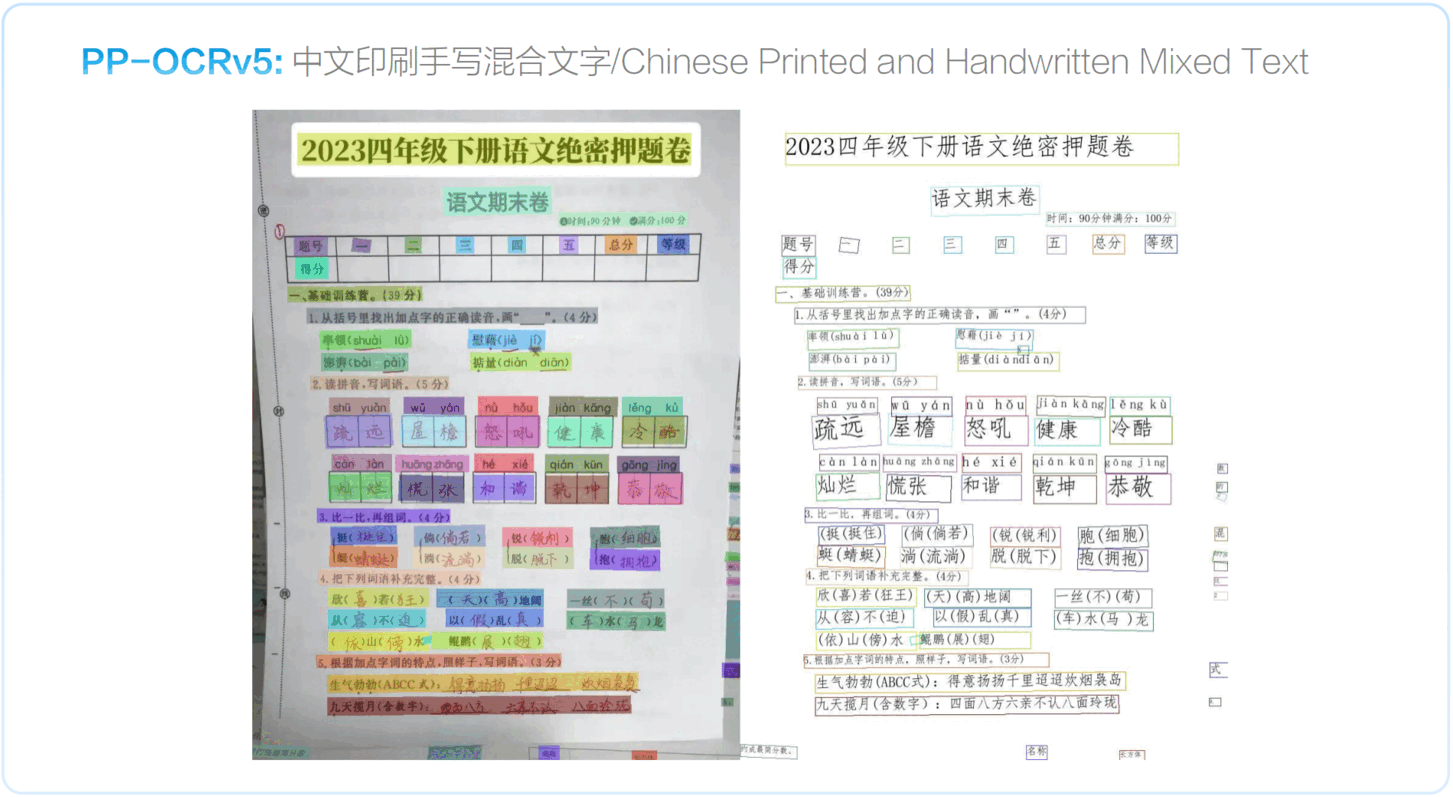
在 3.7.0 版本中,项目引入了 PP-OCRv6 统一模型、轻量视觉语言模型 PaddleOCR-VL-1.6 以及 PP-StructureV3 文档结构分析模块。其中 PP-OCRv6 单一模型即可覆盖中、英、日及 46 种拉丁语系共 50 种语言,无需切换模型就能处理多语言混合文档;
多语言识别与版面解析能力
项目支持 100 多种语言的文字识别,覆盖从拉丁语系到中日韩等复杂字符系统。PP-StructureV3 引入多粒度版面分析,能够识别文本块、表格、图片、公式等复杂元素;
在模型选择上,项目提供 tiny(1.5M 参数)、small(7.7M 参数)、medium(34.
推理性能与硬件适配
推理性能方面,CPU 端通过 OpenVINO 可获得 5.2 倍加速,Apple M4 芯片上达到 6.1 倍加速,A100 GPU 单次推理仅需 0.13 秒。
推理引擎配置上,可在 PaddlePaddle 静态图、PaddlePaddle 动态图、Transformers 等框架之间自由切换,适配不同开发环境。
生态集成与运行核对建议
该工具包已被 Dify、RAGFlow、Cherry Studio 等 AI 应用项目采纳,并深度集成 Dify、RAGFlow、Pathway、Cherry Studio 等主流 AI 平台,提供 Python、CLI、Go、TypeScript、浏览器端等多语言 SDK。
运行前建议先核对本机 Python 版本是否在 3.8-3.12 范围内,并确认所选推理引擎与硬件加速方案在当前环境中可用;
界面预览