长音频转录为何需要额外处理层
Whisper 本身识别能力不弱,可一旦进入字幕制作或多人会议记录,句子级时间戳的偏差就会暴露出来,长音频跑起来也不够快。WhisperX 选择不重新训练模型,而是在 Whisper 或 faster-whisper 之后接上一整套后处理步骤,让时间轴更准、效率更高,并且能分辨不同发言者。
这套源码用 Python 写成,结构上以语音识别后的加工环节为核心,既能拿来直接部署,也留出了二次开发的余地。
从有效语音到逐词对齐再到分人
处理一段录音时,WhisperX 会先定位真正有人声的片段,把静音部分排除在外,降低长空白段引发错误识别的概率;随后交由 Whisper 或 faster-whisper 得到初步文本;再用 wav2vec2 做强制对齐,把时间单位从句子收窄到单词;有需要时再借助 pyannote 区分说话人。
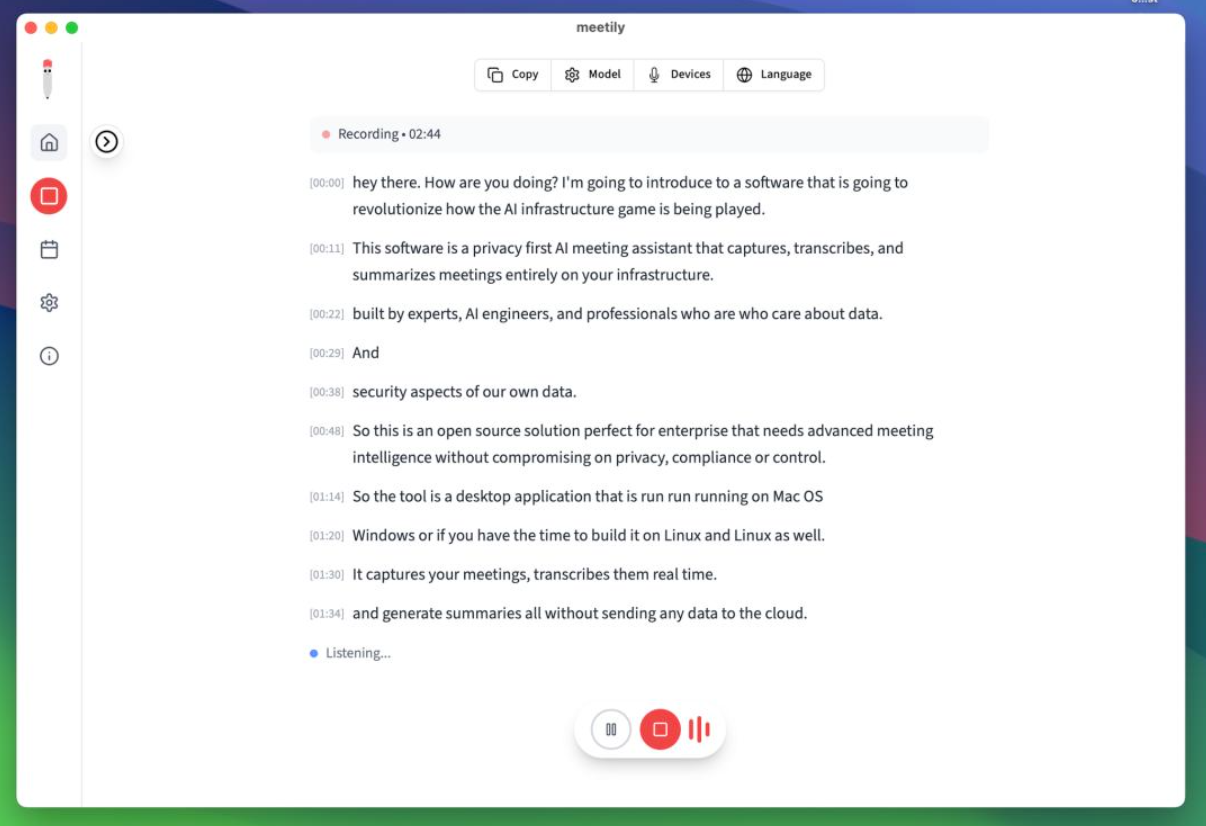
经过对齐的输出,在制作 SRT、VTT 等字幕格式时与音频的贴合度明显更好,也能生成带有细致时间信息和发言者标记的 JSON。面对访谈、播客或多人会议,文本中会出现 Speaker 1、Speaker 2 一类的标识,整理和查找发言内容都更顺手。
速度、硬件与结果用途
批量推理由 faster-whisper 后端承担,若手头有 GPU 可以调用以压缩长音频的整体耗时;短音频或对速度没有苛求时,纯 CPU 环境同样能跑完转录。
产出的文本可以直接进入字幕制作、会议纪要归档,也能当作后续音频分析流程的前置输入。
动手之前要落实的几件事
开始部署前,先确认机器上有可用的 Python 环境,然后安装 WhisperX 及其依赖。由于底层会用到 faster-whisper、wav2vec2,以及可选的 pyannote-audio,第一次运行时还需要下载相应模型文件。
想要更快的批量推理速度,可以准备可选的 GPU 加速环境;若要用到说话人分离,则需按需配置 pyannote 模型。