开发语言Python
资源大小10.14MB
运行环境Windows / macOS / Linux / Web
资源状态可查看
适合搭建内容聚合门户的场景
当前资源围绕Python+HTML展开,这套源码面向热搜或热门榜单的内容聚合需求,整体是一套全栈开源代码。它把多来源榜单的抓取、处理和展示串成一条链路,适合需要快速搭建聚合页面的使用者参考。
项目采用前后端分离架构:后端由 Python 多线程程序驱动,从自带的 30 多个网站采集规则中抓取内容并生成标准 JSON;前端由纯 HTML 和 JavaScript 消费 JSON 数据完成页面呈现。
采集、处理与前端呈现的配合
后端负责定时采集、数据处理和链接加密,处理环节包括时间标准化与去重,最终输出标准 JSON 文件。资料称多线程方式可在 5 秒内完成 30 多个目标网站的数据采集。
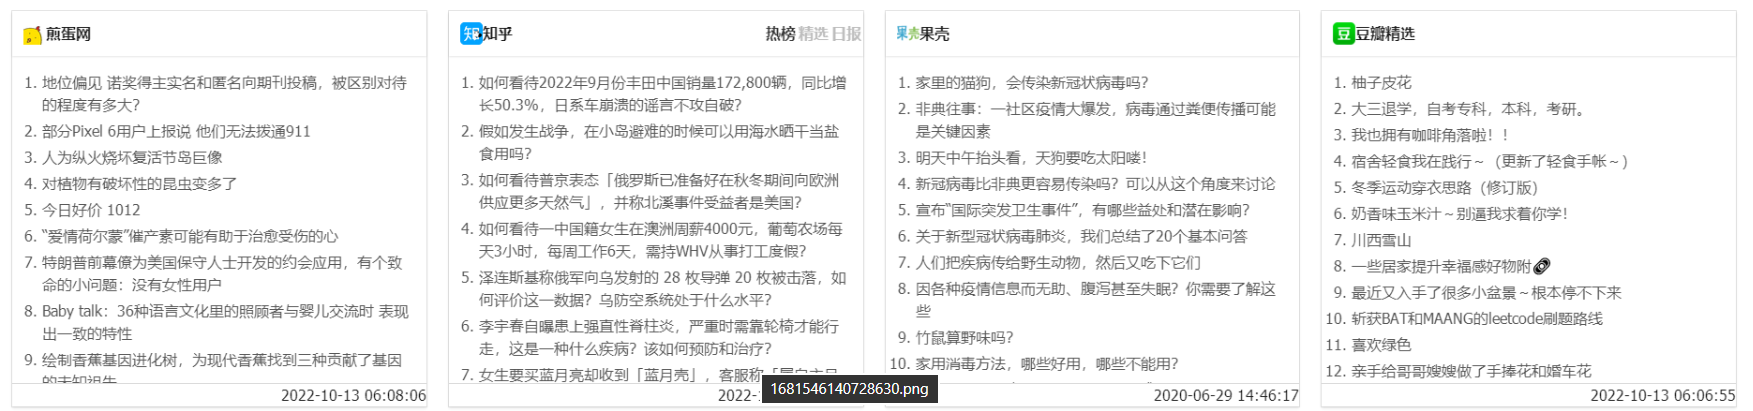
前端通过 Ajax 获取 JSON 数据,实现页面渲染、局部刷新和鼠标悬停提示等交互。页面按网站分框架展示,支持局部滚动更新。
链接加密与点击统计模块
源码包含链接加密防盗链设计,对原始链接采用 Base64、字符逆序和大小写反转的多层处理,用于降低盗链风险。
点击统计由独立的 PHP 管理后台 admin.php 承担,统计数据存放在 SQLite 数据库 log.db 中,方便查看链接点击情况。
运行环境与上线前核对
运行平台覆盖 Windows、macOS、Linux 和 Web。部署时需要配置 Python3 环境运行 caiji.py 采集程序,建议用 screen 守护进程,并将前端文件放入 Web 目录。
采集规则已内置,并可通过更换 Cookie 等方式应对反爬策略。为保障安全,建议将 caiji.py 和 admin.php 文件名修改得复杂一些,或移出 Web 可访问目录。
界面预览