开发语言未说明
资源大小24.42MB
运行环境Windows / Linux / macOS / Web
资源状态可查看
从非结构化文档到结构化数据
MinerU由OpenDataLab团队打造,定位是开源文档解析基座,用来把PDF、图片和Office文档中的内容转成机器可读的Markdown或JSON。
对需要为LLM准备训练语料、为RAG知识库搭建检索源头,或为Agent系统提供文档理解能力的用户来说,MinerU提供了一条从原始文档…
格式覆盖与识别能力
输入侧原生支持PDF、JPG/PNG/TIFF图片、DOCX、PPTX、XLSX五种格式,端到端输出结构化数据,不需要额外格式转换工具。
识别环节采用VLM与传统OCR协同的双引擎策略,支持109种语言的文字检测与识别,对扫描件、手写体和模糊图像均有处理能力。数学公式会转换为LaTeX格式,表格则输出为HTML结构,支持合并单元格与跨页表格还原。
使用方式与部署形态
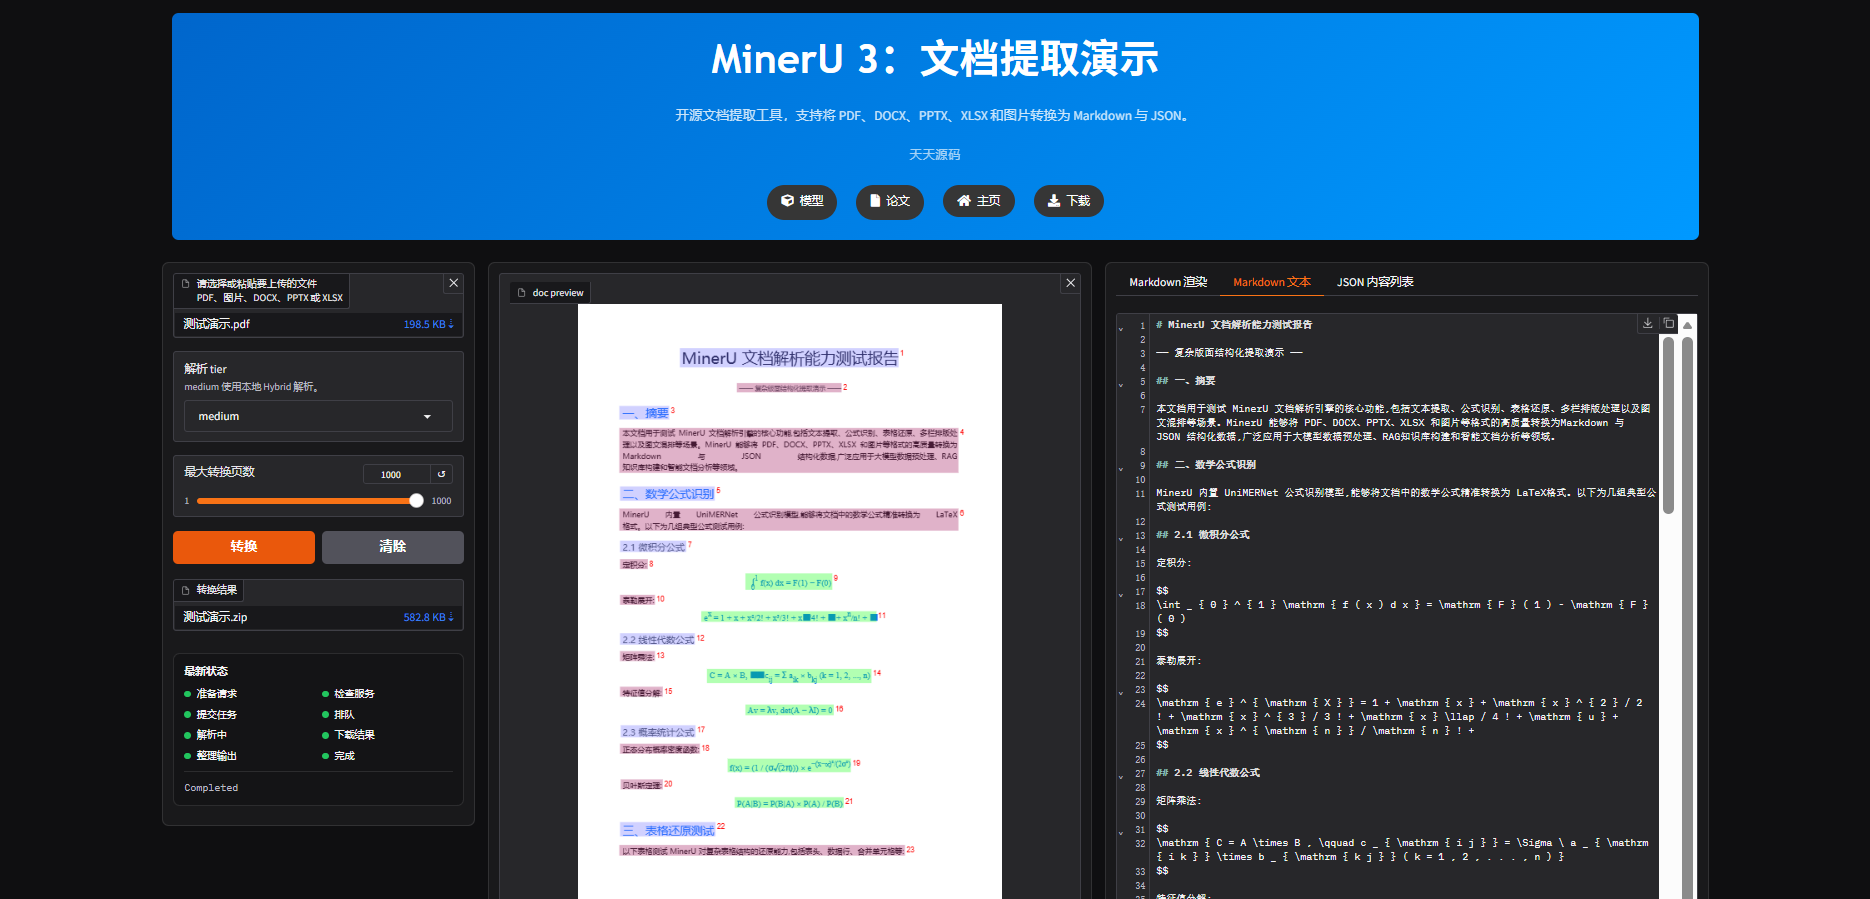
MinerU提供命令行工具(CLI)、FastAPI服务接口和Gradio WebUI三种使用模式,支持单机部署。通过WebUI可以上传文档、查看解析进度与结果,并导出结构化数据;
运行环境方面,它支持纯CPU环境,也支持GPU加速,并适配了十余款国产算力平台。Hybrid low模式针对纯CPU环境优化,内存占用较低,可在云服务器、边缘设备乃至树莓派上运行。
配置、扩展与下载前核对
项目基于Python开发,后端使用深度学习框架与计算机视觉模型。整体采用模块化设计,版面检测、文字识别、公式转换、表格重建等环节均可独立替换与扩展,方便研…
配置层面支持YAML文件、环境变量与命令行参数,可调整OCR语言包、版面分析阈值、输出格式、缓存策略、GPU设备编号和并发线程数等。大规模批量处理时,可通过FastAPI上传任务队列,结合mineru-router组件进行多卡编排与多节点分布式调度。
界面预览